能自己学习的机器长啥样?身边的AI盘点
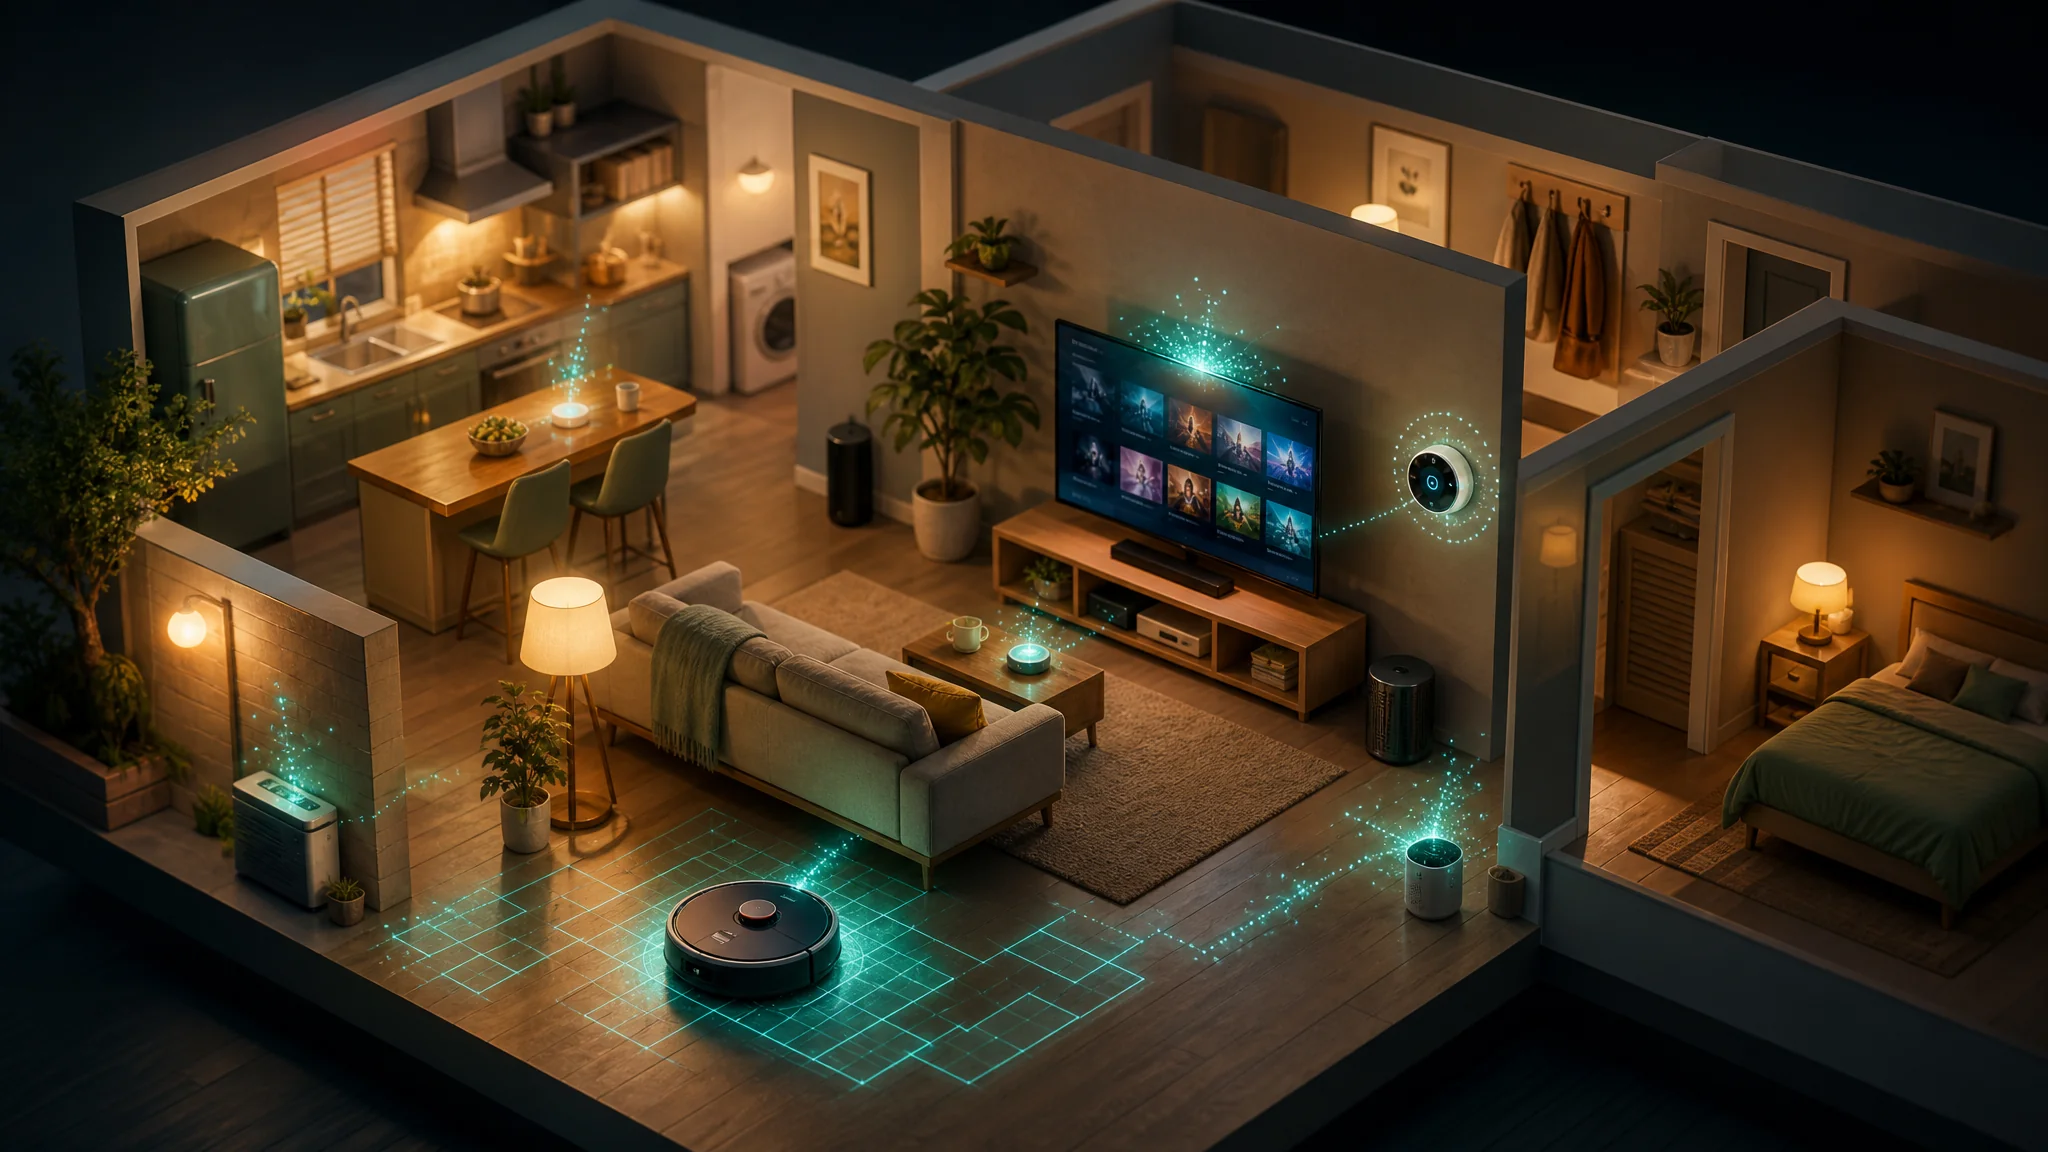

简单说:ai能学习的机器早就住进你家了,扫地机器人、手机相册、外卖推荐都是。它们的学习本质是"从数据里找规律再改行为",学得深浅差很远。别神化,也不用害怕。
手机就是ai能学习的机器里最典型的代表。上周我妈问我:"手机咋知道我爱看做菜的视频?"她一脸警惕。我给她解释了十分钟推荐算法,她回了句"哦,跟喂狗似的"。别说,还真被她说中了。
这篇就干一件事:把家里和手机里那些会自己变聪明的机器挨个拎出来,用大白话讲它们到底怎么学、学得怎么样。看完你会发现,AI一点都不神秘,神秘感都是营销给的。
ai能学习的机器,判断标准就一条
一台机器算不算会学习,不看它多智能,看它的行为会不会根据经历变好。出厂时一个样,用三个月变了个样,这就是在学。只是这种学习不靠脑子,靠数据和算法。比如输入法。你新买手机时,打"hhh"它给你出"哈哈"都得猜。用俩月,你打"zdm"它直接出"怎么了妈"。它把你的输入习惯攒下来当了教材,这就是最朴素的学习——统计规律。
跟我妈说的喂狗是一个理。做得对给块肉(数据里被奖励的行为得到强化),做得不对没肉(出现少的组合被弱化),喂得久了,它就懂你了。这个路数在学术上有个正经出处,维基百科的机器学习词条开篇讲的就是"从数据中自动学习规律"这个定义,跟我妈的喂狗论殊途同归。
拆到最底层,机器学习就仨步骤:攒例子、找规律、用规律。听起来是不是很土?很土就对了,土的东西才跑得稳。
第一台:扫地机器人,最容易被高估的学习者
扫地机器人的"学习"主要是建图和避障:用传感器扫描房间生成地图,碰撞数据帮它记住哪有台阶。但它不会学"怎么扫得更干净",清洁策略基本是出厂定死的。我家那台用了两年,我对它太有发言权了。头一个月它天天撞茶几,第二个月开始提前减速绕开——这确实是在学,学的是空间。可让我不满意的点也很明确:它永远学不会餐桌底下那把椅子是重灾区,每次都按固定频率扫,不会因为那里脏就多去几次。
我拆过它的APP数据看(职业病),它记录的是路径和障碍物位置,没有一张"脏污分布图"。就是说,它长了记性,没长心眼。这代产品离"真·智能清扫"还有距离,买的时候别为"深度学习"四个字多掏钱,多数机型的学习模块跟旗舰款压根不是一个东西。
第二台:手机相册和输入法,藏得最深的学习大户
手机相册的人脸聚类和场景识别,是端侧机器学习最成熟的落地:照片喂进去,模型自动把娃的脸归成一组、把沙滩归成一组。它在你手机里日夜学习,你却从没感觉。我做过一个小实验:给我妈的手机相册里连存两百张广场舞照片,一周后搜"跳舞",准确率肉眼可见地上来了(部分机型有本地个性化)。输入法更夸张,它的联想模型隔几天就重训一次,你的口头禅会慢慢爬到候选词第一位。
这俩的学习机制值得一提——大部分在你手机本地跑,不联网。苹果、小米这些厂商这几年都在推端侧模型,好处是隐私数据不出门。想深入了解手机芯片怎么装下AI的,看我之前写的手机AI芯片NPU拆解,原理讲得比这篇细。
第三台:推荐系统,学得最狠也最让人警惕
推荐系统是当今学得最凶的机器:你每划一下都是给它喂教材,停留两秒算喜欢,三秒划走算不喜欢,几千个特征实时更新对你的画像。它学你,比你自己了解自己还快。我说个自己被拿捏的实例。有阵子我睡前刷短视频,随口完整看完了一条装修避坑的视频——就一条。接下来两周,我的信息流里装修内容占了半屏。它从一次两分钟的停留里,学会了对我的判断,然后不停试探性加码、看反应、再加码。
这套机制的名字叫协同过滤加深学习排序,说人话就是"跟你口味像的人爱看啥,就给你推啥,再按你的真实反应微调"。工程上它靠海量用户行为数据驱动,效果确实好。按Statista的统计,全球互联网用户每天泡在社交媒体和短视频上的时间加起来超过20亿小时量级,这些时长背后全是喂给推荐算法的教材。好到什么程度?字节、快手这类公司的推荐算法团队规模都是千人级的,只为让你多划十分钟。
知道原理后我的建议是:别跟它斗智,直接管时间。它学你的速度,比你自律的速度快多了。认了吧。
话说回来,盘点这些机器的时候我总有点感慨。十年前"机器自己学习"还是新闻标题,现在它蹲在你家地板上、揣在你兜里、藏在你的外卖软件里,安静得像不存在。
这些机器的学习和人的学习完全是两码事。机器不懂因果,只认相关:它不知道"你半夜看吃播是因为饿",只知道"半夜和吃播经常同时出现"。想弄明白这层差别的,推荐AI和人类学习的三点差异,比我说得透。
给身边这些会学习的机器排个座次
按学习深度排序:推荐系统大于手机相册大于输入法大于扫地机器人。前三个学的是你的行为,最后一个只学空间。越靠近内容消费的机器学得越深,这规律基本成立。依据是可调参数量和数据更新频率,推荐算法的模型动辄上百亿参数、实时更新;扫地机器人的地图模型,参数量级差了十万八千里。
再补一个容易被忽略的:智能家居中枢。我家的音箱现在能根据我的作息自动调晚上的灯,这个"学"其实是规则触发器套了个AI的皮。有的学习是真的,有的是文案。分不清的时候,看它会不会随时间变更准,不会的就不是在学。
这个层次关系要展开讲就深了,和AI与机器学习的层次关系那篇对照着看,你会更清楚哪些机器是真AI、哪些是营销AI。
常见问题
ai能学习的机器会越用越聪明吗,有上限吗?
有上限。它们的"聪明"受算法框架和数据质量双重限制,手机端的学习模块还有存储和算力天花板。所以输入法学两年后,提升会明显放缓,因为它能从你身上挖的规律就那么多。
这些机器的学习会泄露我的隐私吗?
分两种。端侧学习(相册、输入法本地模型)数据不出手机,风险低;云端学习(推荐系统)数据要上传,风险看厂商的合规水平。我自己的做法是相册本地化功能全开,云端个性化能关就关。安全边界展开讲可以看AI和机器学习安全吗那篇。
机器学习和深度学习是一个东西吗?
不是。机器学习是大概念,深度学习是其中用多层神经网络的那一支。扫地机器人建图用的大概率是传统机器学习方法,推荐系统排序层才用深度学习。关系像交通工具和高铁,别混着叫。
能让家里的机器互相学习、组成全屋智能吗?
目前做不到理想状态。各品牌设备的数据互不相通,所谓全屋智能更多是联动规则,不是共同学习。想体验真·联动,选同一生态的设备,跨品牌的学习协作还要再等等。
盘点完这一圈,ai能学习的机器名单还会继续变长,明年可能就轮到你的汽车座椅和电饭煲了。机制记住一条就够用:它们都在从你的数据里找规律。看懂了这点,下次再看到"AI智能"四个字,你先问一句"它从哪学",就不会被忽悠。觉得这篇把你家电器讲明白了,转给家里那位对手机保持警惕的长辈,比一百句解释都管用。