AI机器学习算法模型入门:从线性回归到神经网络的通关顺序
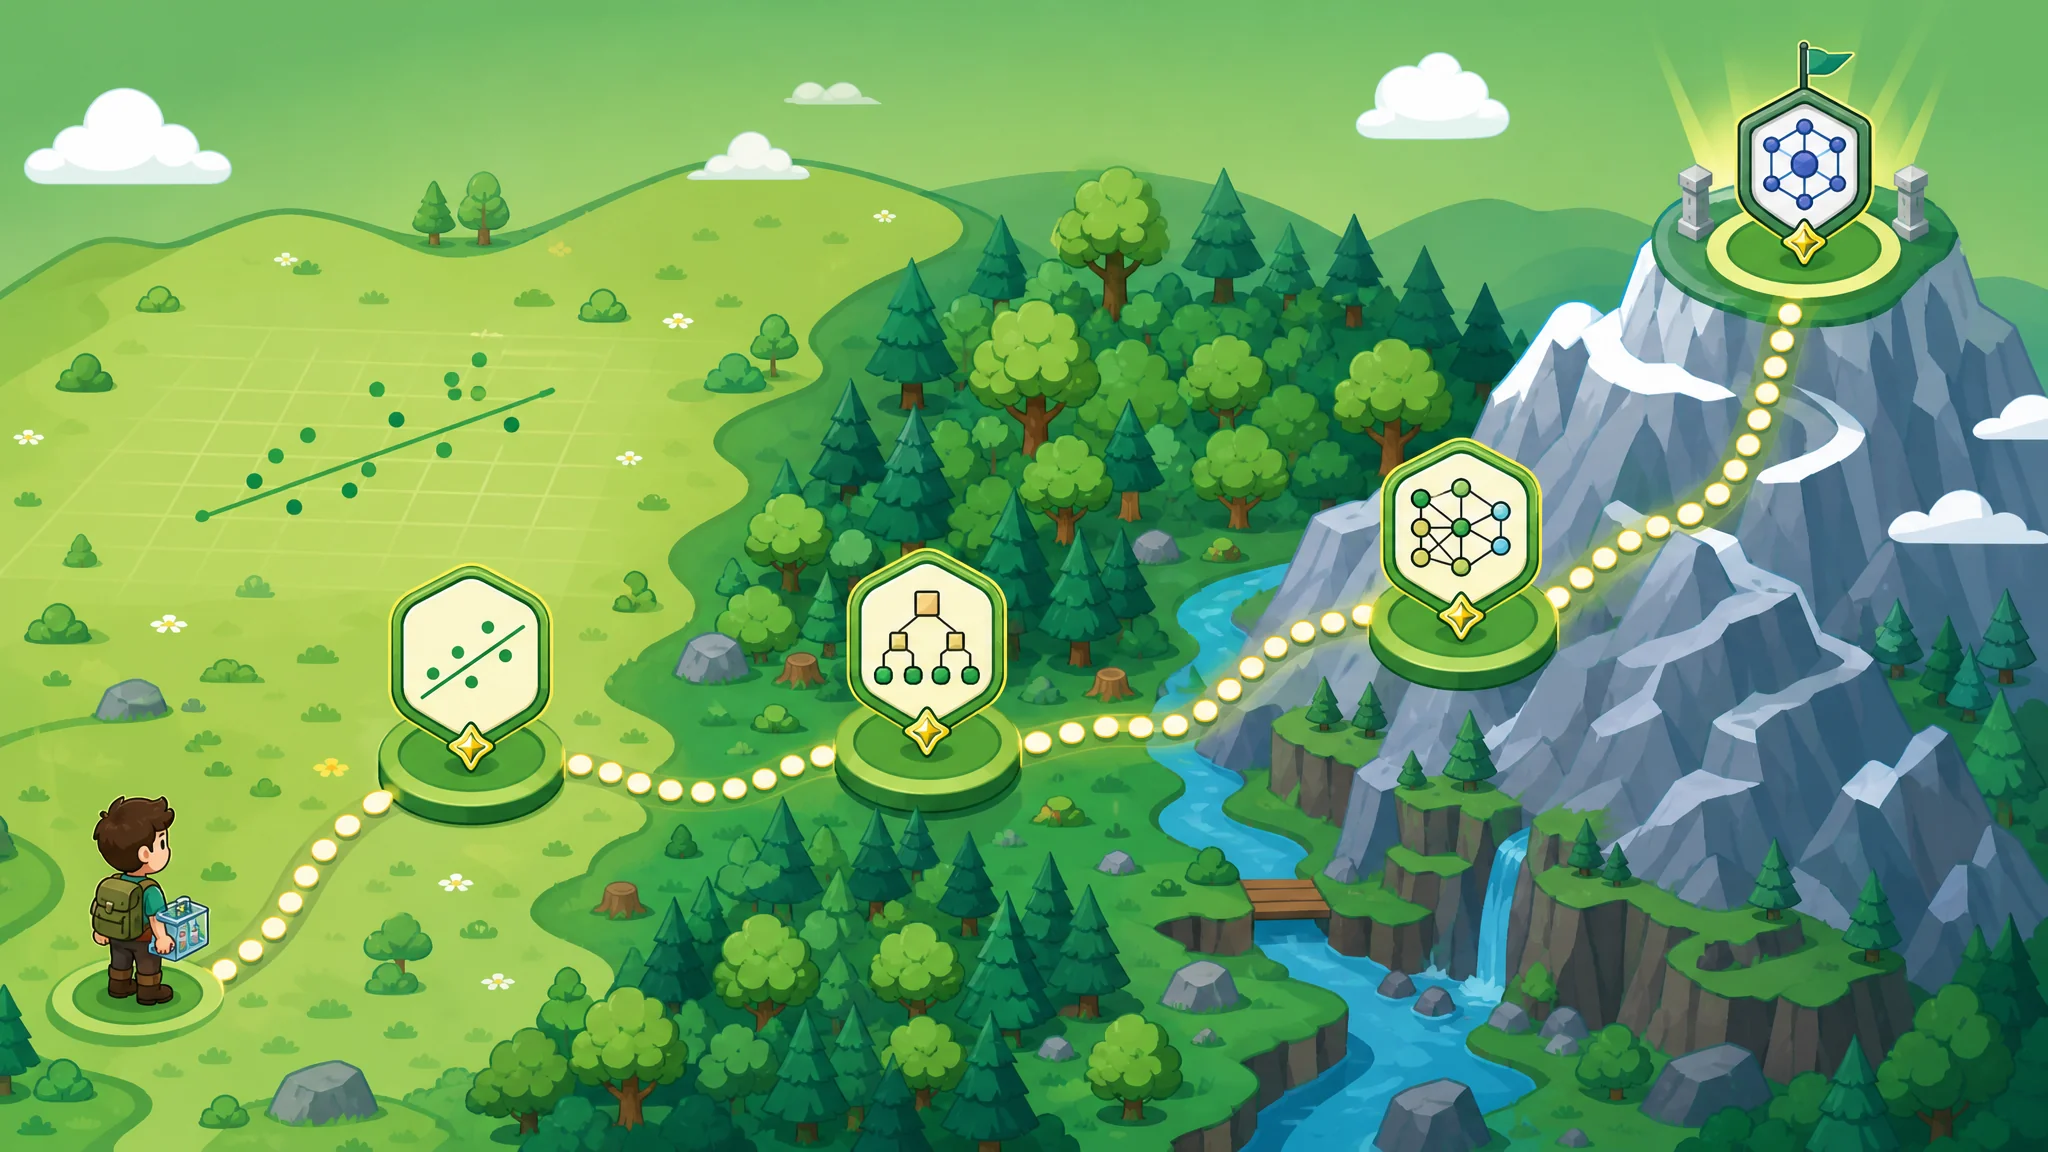

简单说:ai机器学习算法模型入门别从神经网络学起,先啃线性回归和逻辑回归这类"傻"算法,把训练、验证、过拟合这套手感练出来,再上树模型和神经网络。全程认真学约需三个月,我按自己走过的顺序给你排好了每一站。
ai机器学习算法模型怎么入门?两年前的我是个连Python都写不利索的文科生,现在能独立跑通小型建模项目。这条路我一步步蹚过来的,踩过的坑比学会的算法还多。这篇就把通关顺序掰开讲:每个算法配一个我用的生活比喻、一个亲手跑过的小实验,还有真实耗时。先说个扎心发现:入门最大的敌人不是数学,是顺序错了导致的挫败感。我一上来就学神经网络,两周后差点放弃,后来回头从最傻的线性回归学起,反而顺了。
第一站线性回归:ai机器学习算法模型里的"量体温"
原子答案:线性回归就是找一条直线,让预测值和真实值的误差最小。它是所有算法的原型,训练、损失函数、调参这些概念在这里第一次全部出现。给它一周,性价比是全程最高的。
我的比喻是量体温猜体重:你统计了班里50个人的身高体重,画在坐标轴上,肉眼就能看出"个子越高越重"的趋势,线性回归干的就是把这条趋势线精确画出来。它看着土,但"用数据预测一个数"这个机器学习的灵魂,它全占了。
我当时的实验是拿房价数据集预测二手房价格,在Colab上跑的,免费GPU都没用上。第一次跑出预测曲线那天晚上挺兴奋的,虽然误差大到离谱。真不是夸张,我预测120万的房子它给我出95万。但那次我搞懂了一个核心概念:损失函数就是"猜错的程度",训练就是不断调整让猜错变少。这个心智模型,后面所有算法都通用。
耗时记录:原理加动手,一周够了。数学部分别死磕推导,会看结果会调参就行,梯度下降的推导我当年抠了三天,回头看完全没必要。
第二站逻辑回归:从"猜多少"变成"猜是不是"
原子答案:逻辑回归名字带回归,实际是分类算法,回答"是不是"的问题,比如这封邮件是不是垃圾邮件。它在线性回归外面套了一个把数值压到0到1之间的函数,输出可以当概率看。建议花五天。
比喻我用的这个:线性回归是预测明天降雨量多少毫米,逻辑回归是预测明天要不要带伞。前者输出一个数,后者输出一个判断。带不带伞,本质就是降雨概率超过某个阈值没有。
我的实验用的泰坦尼克号乘客数据集,预测谁能活下来。这个数据集小,八百多条,特征就年龄、性别、舱位几个,特别适合新手第一遍跑通完整流程。我第一次跑出来准确率0.78,激动地发朋友圈,后来才知道瞎猜"全死"都有六成准头。挺泄气的。但也是那次我学会了看混淆矩阵,知道准确率会骗人。
这一站最大的收获是理解了"分类阈值":概率0.5切一刀,挪到0.3或0.7,抓对和抓错的比例就变。做风控的朋友跟我说,他们宁可错杀,阈值就往严了调。算法没有温度,调阈值的人有。
第三站决策树和随机森林:最像人类思考的算法
原子答案:决策树就是一连串"如果...就..."的追问,随机森林是一大堆决策树投票,票多的说了算。这一站无需新数学知识,是入门路上最轻松的一段,还能第一次体会"集成"思想的威力。给它十天,含实验。
比喻是老妈相亲式提问:有房吗?没有。有车吗?没有。那算了。这就是一棵决策树,每个问题就是一个节点,问到底得出结论。随机森林则是找一百个七大姑八大姨各自问一遍,最后举手表决。
我的实验还是泰坦尼克数据集,换成随机森林后准确率从0.78提到0.83,一行代码的事,当时感觉像捡了便宜。真正让我开眼的是特征重要性输出:模型告诉我"性别"重要性0.29排第一,"舱位"0.25排第二。相当于模型自己交代了它是怎么想的。这种可解释性,神经网络反而给不了。
老实讲,如果只让普通人学一个算法去解决工作里的小问题,我投随机森林。上手快,不太要调参,表格类数据效果好。我后来帮朋友的小店预测过哪些客户会流失,就是用它,两个小时搞定。
第四站聚类:没有标准答案的算法
原子答案:聚类是把相似的东西自动归堆,它没有标准答案,不需要提前标注数据,属于"无监督学习"。前几站都是照着标准答案学,这一站开始要自己判断结果好坏。一周时间,重点体会思维方式的转变。
比喻是整理一柜子没标签的快递:你不知道每个包裹是谁的,但按大小、重量、形状分堆,分完每堆看起来就是"一类东西"。聚类干的就是这个,只不过它按数据特征分。
我的实验拿外卖平台公开的门店数据做客户分群,用K-means聚成三类后画出来:一类高频低客单,一类低频高客单,一类不温不火。分完有个尴尬的事:分几类是我自己定的,聚成四类五类也说得通。这就是聚类的坑,结果依赖人的判断。我纠结了一晚上,最后靠"业务上能不能落地"来定:三类每类都能配一套运营动作,四类有一类只有几十个样本,没意义。
这一站教我的事:机器学习里不是所有问题都有对错,能落地比"科学正确"重要。
第五站神经网络:终于摸到深学习的门
原子答案:神经网络把一堆简单的"加权打分器"层层叠起来,每一层把上一层的输出再加工,层数深了就叫深度学习。到这一站你前面攒的概念全部复用,新东西只有一个:网络结构。认真学要一个月,是前四站加起来的量。
比喻我打磨了好久才想明白这个:判断一张脸是不是好看。第一层看五官比例,第二层看五官搭配,第三层综合出"顺不顺眼"。每一层都干点简单活,叠起来就成了复杂判断。单看一层 dumb 得很,合起来吓人。想先补概念背景的,可以翻翻AI深度学习是什么的白话讲解,把神经网络在讲什么先有个轮廓。
实验必须做图像识别,我用的是手写数字MNIST数据集,网上教程遍地都是。第一次跑通时训练准确率99%,我盯着屏幕愣了半天。就几十行代码,教电脑认字,这事儿放二十年前是博士论文级别的活。不过冷静下来看测试集,96%,掉的那3个点让我理解了过拟合:模型把练习题答案背下来了,考试还是错。
这一站我开始补数学,但只补了两块:矩阵乘法和链式求导。够用了。微积分课本别的章节我一页没翻,别被"先学完数学再学算法"的说法吓住,那是劝退率最高的路线。
顺序讲完了,说点顺序之外的事。我第三个月差点弃坑,卡在神经网络的反向传播,看了五套教程没一套看懂。当时的自救动作是退回第四站,用两周把前面的项目全部重做一遍。神奇的是,重做时发现逻辑回归里那个"压到0到1的函数",不就是神经网络每个神经元的原型吗。回去再啃反向传播,通了。
所以给你一条我拿挫败感换来的经验:卡死的时候别硬顶,退一站再上来,比换十套教程管用。
通关时间表和验收标准
原子答案:线性回归7天、逻辑回归5天、树模型10天、聚类7天、神经网络30天,总计约三个月,每天投入2小时。验收标准只有一条:每一站都能不抄教程、独立跑通一个自己的小数据集实验。
展开成一张表,是我自己的实际记录加修正。排序思路参考了自学时梳理过的AI算法先啃透三个的主张,核心一致:宁可慢,别贪多:
| 算法 | 我的实际耗时 | 建议耗时 | 验收实验 | 主观难度 |
|---|---|---|---|---|
| 线性回归 | 9天(走了弯路) | 7天 | 房价预测 | 两星,概念多但都不难 |
| 逻辑回归 | 6天 | 5天 | 泰坦尼克生存预测 | 两星,重点搞懂阈值 |
| 决策树/随机森林 | 8天 | 10天 | 客户流失预测 | 一星半,最轻松的一站 |
| 聚类 | 7天 | 7天 | 客户分群 | 三星,难在没标准答案 |
| 神经网络 | 34天 | 30天 | MNIST手写识别 | 四星,卡壳属正常 |
表里加了一列主观难度,是我个人的体感,仅供参考。有意思的是耗时和难度不成正比,聚类看着轻,心智上的转变最费劲。资源方面,谷歌的Machine Learning Crash Course和scikit-learn官方用户指南陪我走完前四站,神经网络那段靠的是PyTorch官方教程。都是免费的。另外前四站的练习我全在云上跑,配置方面的顾虑可以看跑机器学习要什么配置的电脑,先别急着花钱。
常见问题
学ai机器学习算法模型一定要先学高等数学吗?
不用先学完,按需补。我的路线是全程只补了矩阵乘法和链式求导两块,加起来不到两周。数学课本那种从极限讲到级数的学法,会把三个月拖成一年,多数人半路就放弃了。
学这些算法需要什么配置的电脑?
入门阶段任何能开浏览器的电脑都行,谷歌Colab免费提供在线算力,前三站连GPU都用不上。到神经网络那站也够用。真到要本地跑大模型再考虑花钱,前期别为设备焦虑,具体可以看看机器学习电脑配置那篇的分析。
学完这五个算法能找到工作吗?
坦白说,只学完这五个还不够直接上岗,但足够你判断自己适不适合这条线,也足够做很多岗位的面试第一轮。从入门到求职中间还差项目经验这一大截,建议每一站都留一个自己找数据做的实验,攒作品比攒证书有用。
写到这我自己都挺感慨的。ai机器学习算法模型这条线,从线性回归那种一个下午就能理解的简单,到神经网络那种看五遍才敢说看懂一点的复杂,三个月走完是紧了点,但每一步都踩实的话,回头看真没那么难。要是你现在正卡在某一站,别怀疑自己智商,我卡过的地方比你惨。觉得这篇顺序表有用,转给一起学AI的朋友,省得他再从神经网络开始硬啃。