帝国时代3的AI什么水平?行为逻辑比红警复杂
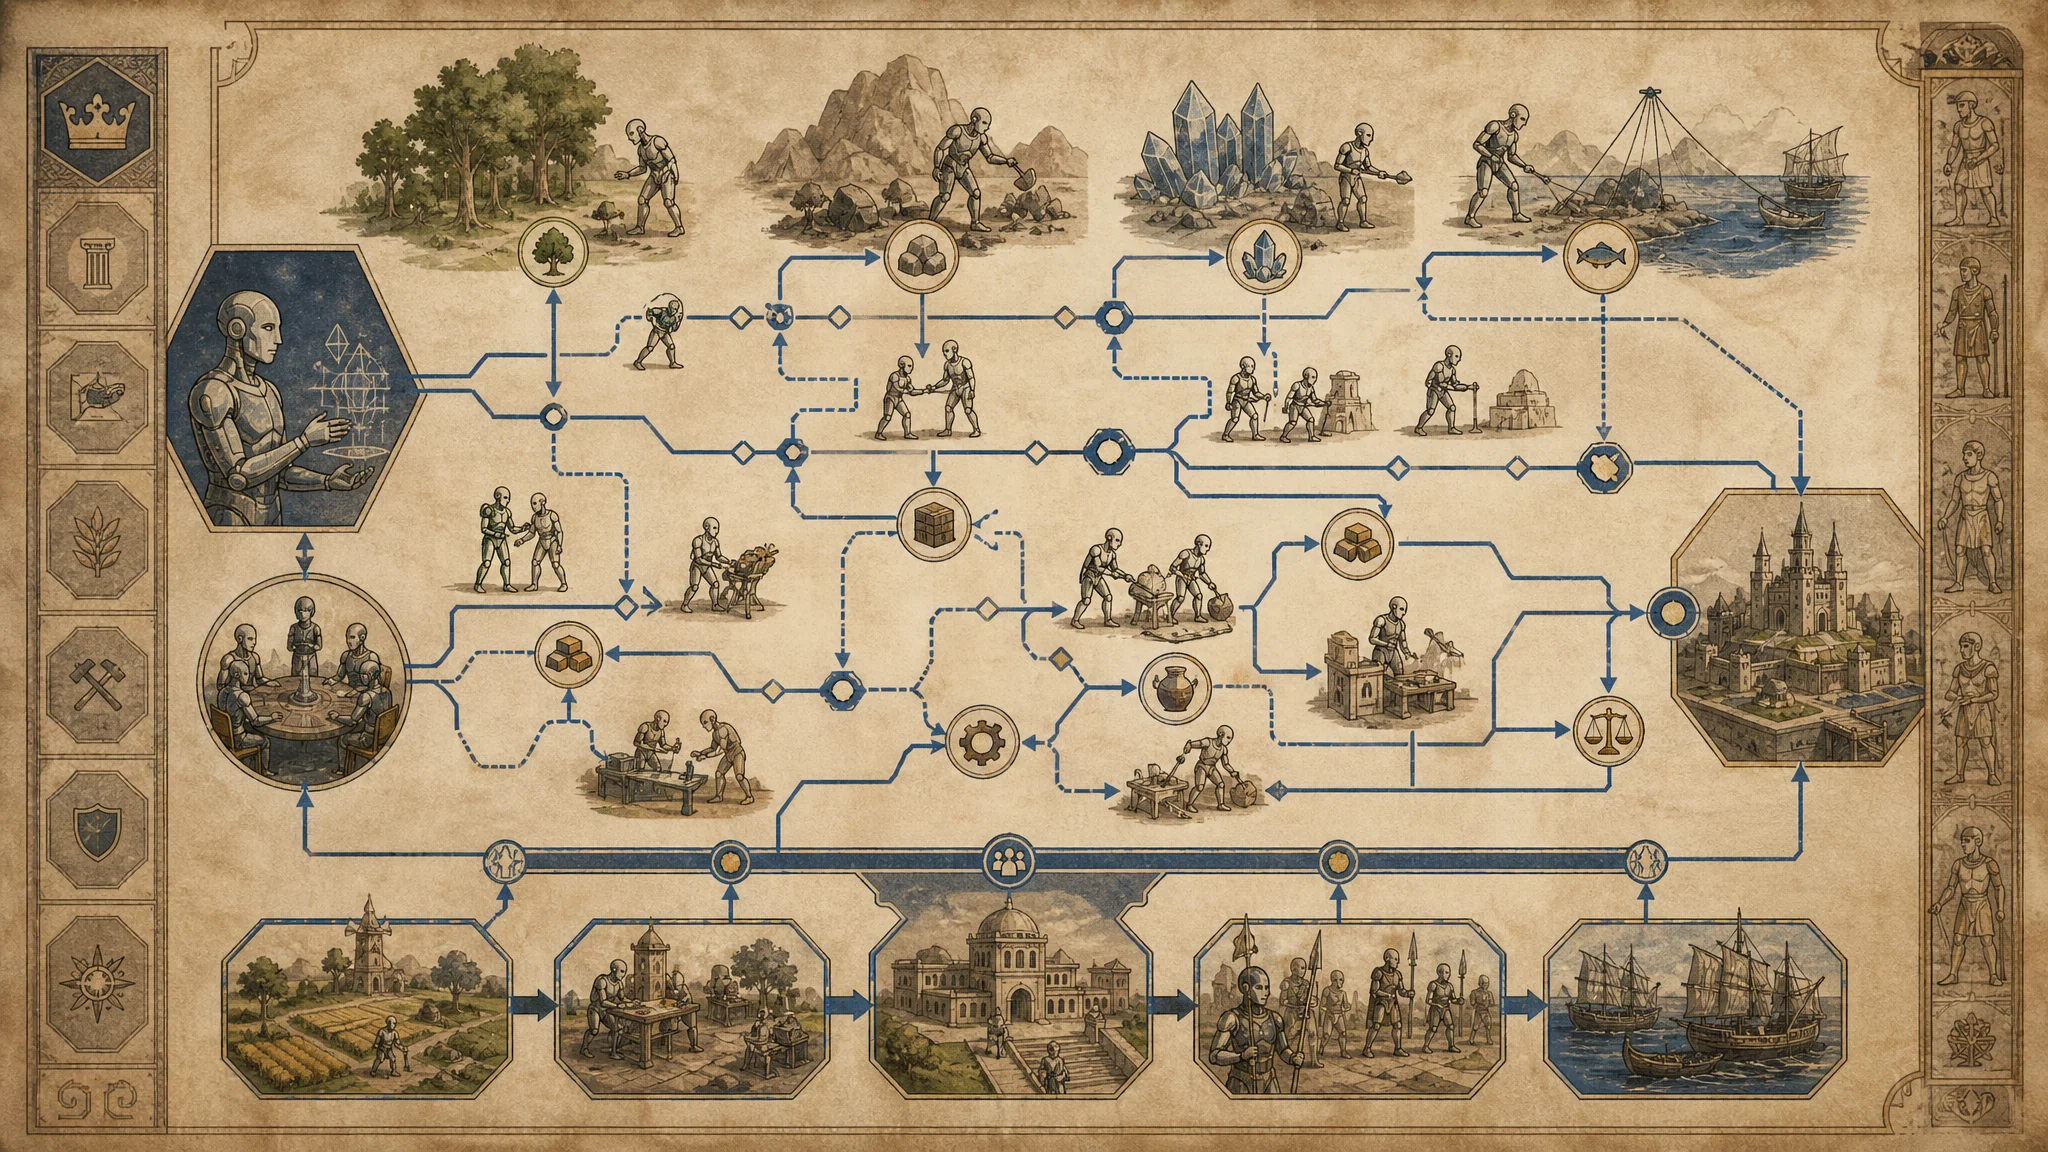

简单说:帝国3的AI比红警3聪明,聪明在会攒经济、会看兵种出兵,但底层仍是查表逻辑,不是学习。两种游戏AI的差距来自规则复杂度,不是算法先进。想理解AI架构差异,拿它俩对比是最好的教材。
帝国时代3AI学习这个话题,是从一次饭局吵起来的。老同学坚持认为帝国3的电脑"会运营",我说那叫脚本写得好。回家我不服气,翻出游戏对着最难级电脑认真打了半个月,录了十二局屏,专门盯着它的经济运营看。越看越有意思——这游戏的AI确实比红警3高一个层次,但高的原因,跟大多数人想的不一样。
先把话放这:它依然不会学习,但它把"查表"查出了花。这篇文章就讲这张表是怎么查的。
我的观察方法交代一下,不然结论没有根基。版本用决定版,1v1黑森林和德克萨斯两张图各六局,难度固定最难。我不追求赢,前五分钟故意不打架,就 observer 模式挂机看它运营(决定版有个观测者延迟功能,方便复盘)。经济建筑的建造顺序、村民的分配流向、每一波兵的配比,我用表格手动记的。十二局记下来,手腕都酸了。
没有金标准对照,这就是个笨人笨办法。但笨办法出真东西。
帝国3AI的经济决策链,拆开是四段流水线
原子答案:帝国3AI的运营分四步循环——派探险家探图圈资源点、按预设序列补经济建筑、村民按采集优先级自动再分配、兵力按克制关系配比。四步都是固定逻辑,但环环相扣,形成的运营水平明显高于红警3的单线出兵。
逐段说。第一段探图,开局两分钟内它的探险家必然摸清你主基地方向,狗的走位都有讲究,优先贴地图边缘绕圈。第二段囤田,这是我印象最深的部分:它的磨坊和农庄不是乱造的,村民数量过20之后,粮食采集的村民占比稳定在55%上下浮动,跟我查的高手录像数据(普遍50%-60%)几乎重合。这个数字是策划调出来的,调得相当讲究。
第三段再分配是精髓。你把它的金矿骚扰掉,它的村民不会傻站着,会在十几秒内被重新分派到伐木或农田。注意,这是"经济系统容错",不是智能——它判断的依据是采集点失效这个事件,触发搬家的固定指令。红警3的矿车被端了也有类似补救,但帝国3的再分配粒度细到单个村民,观感上就"活"很多。
第四段配兵最容易被误读成"学习"。你重步兵,它出骑兵;你重骑兵,它补长枪。看起来像它在分析你、适应你。其实呢?这套克制应对也是预设的对策表。证明方法很损:同一局里我把主力兵种来回切换三次,它的应对每次都精确命中克制表,但从不搞伏击、不预判、不将计就计。查表查得再准,它也不会骗你。
拿红警3对照:帝国3AI学习的"错觉"从哪来?
原子答案:帝国3给AI装了经济系统,决策变量多了一个数量级,容错和再分配逻辑让它显得会思考。红警3的AI本质是出兵计时器。两者都是脚本,复杂度差在游戏规则本身。
上个月我刚好做过红警3的AI实验(同一招打七局,电脑一次都没变),这次正好拿来当对照组。红警3的经济只有矿车采矿一条线,AI的经济行为压缩成"矿车数量"一个变量,剩下的全是出兵序列。帝国3不同,村民采集分四类资源,资源之间还要换算,光"什么时候升时代"这一件事,AI就要在科技、兵力、经济三个方向上做权重取舍。规则复杂,脚本能表演的空间就大。
打个比方。红警3的AI是自动售货机,投币出饮料,动作利索但没有惊喜。帝国3的AI像一台编程好的咖啡机,会根据你的选择调整水温、粉量、萃取时间,花样繁多,可配方还是出厂时写进芯片的。都是机器,一个是查表快,一个是表大。
红警那套的完整实验数据我写在红警3AI会学习吗的验证实验里了,两个实验对照着看,你对"脚本AI"这四个字的理解会立体很多。红警3的出兵套路拆解,另有看懂电脑对手出兵套路一篇,细节更全。
讲个翻车现场,帝国3的AI蠢起来也是真蠢。第八局,我故意在它必经的隘口造了个贸易站卡位,它的部队在隘口前集结了整整四分钟,来回踱步,就是不肯拆。最后居然绕了半张地图从侧翼包过来。战术上你可以说这叫迂回,我看着更像是寻路逻辑卡了 bug。旁边我表弟笑到拍大腿:这AI跟我打的不是一张图。
还有它的时代升级时机。十二局里它升三代的节点误差不超过90秒,稳定得像地铁时刻表。稳定是脚本的美德,也是它的死穴——你掐着它的升级节奏打时间差,基本一打一个准。我后来六连胜全靠这一招,赢了也没啥成就感,赢的是张表。
游戏AI到底有没有真在用机器学习?
原子答案:商业即时战略游戏的对战AI几乎清一色是脚本和有限状态机,机器学习只活跃在科研项目和棋牌类。不是技术做不到,是可控性和开发成本不划算。
DeepMind用强化学习练出的AlphaStar在星际争霸II上达到过宗师段位,这是公开可查的事实,AlphaStar的词条里有对局细节。但商业游戏厂商为什么不跟进?我问过做游戏开发的朋友,他的原话是:"训练出来的模型策划改不动,出了平衡性问题只能重新训练,成本炸裂。脚本今天改表明天上线。"一句话讲透行业现实。学术界把这件事研究得更透,《自然》杂志收录过AlphaStar的完整论文,结论部分就讨论过这类AI在商业环境落地的成本障碍。
脚本AI还有个隐藏优势:性能。帝国3的AI决策跑在你本地CPU上,查表的开销约等于零;换一个神经网络推理,低配机器的帧数先扛不住。所以你现在买的任何一款RTS重制版,对战AI骨子里还是2005年的技术,顶多把表填得更漂亮。
想顺着这条线把AI的"学习"彻底搞明白的,推荐三篇:机器学习入门白话版讲AI怎么从数据里学;游戏AI强化学习入门讲让AI自己打游戏是怎么回事;机器学习六个月学习计划适合想把这套东西亲手跑一遍的人。由浅入深,顺序别乱。
帝国时代3AI学习的观察框架:两条标准判断游戏AI水平
原子答案:判断一个游戏AI的水平,一看它的决策是响应式还是预测式,二看它的失误是否可复现。两条都指向"查表",就能定性它是脚本;有预测、有不可复现的失误,才可能有模型。
框架说起来简单,用起来意外地顺手。响应式指它只对已发生的事做反应,比如兵种克制表,你出了它才应对,永远慢半拍;预测式是它会在你没出招前布局,比如提前在你分矿路上设伏。帝国3的AI全程响应式,一次预测都没做过。失误复现更好验证,我在同一张图重开三次,同样的开局,它前五分钟的建筑顺序一字不差。真模型可做不到这么齐整,神经网络的输出天然带随机性。
这两条我后来拿去测了手机上的自走棋和一台"智能"扫地机器人,全都能用。说白了这个框架的价值不在游戏,在于给你一双拆穿"智能"包装的眼睛。现在啥产品都敢往自己身上贴AI标签,会拆,就不会被营销话术带着走。
关于AI学习的原理性追问,比如"机器到底怎么从经验里变强",可以接着读让AI学习的原理,数据喂养到模型毕业的完整流程都在里面。那份红警3的对照实验如果还没看,回头补上,两篇是一套的。
常见问题
帝国3最难AI的经济运营能到什么水平?
按我的十二局记录,二十分钟时它平均能维持55到60个村民、资源采集分配接近高手录像的比例。运营框架是及格的,短板在战术欺诈为零,时间点又太规律,掐表就能反制。
帝国3的AI会针对玩家的战术做调整吗?
会应对,不会针对。你出什么兵它按克制表补什么,但不存在"预判你要打快攻所以提前修塔"这类预测行为。把同一招用两局,第二局它的准备和第一局完全一样。
决定版的AI比2005年原版有升级吗?
有,主要是表填得更细、难度档位更多,个别加了些开局变体,但架构没换,仍是行为规则那套。所以原版时代总结的AI弱点,决定版大多还能用。
有没有AI真的会越玩越强的游戏?
棋牌和科研向对战环境里有,AlphaStar就是代表。商业游戏里基本没有,玩家遇到的"变强"要么是难度加成,要么是剧情脚本,跟持续学习不沾边。
半个月十二局打完,我对帝国时代3AI学习这个问题的最终回答是:它不学习,但它证明了一件事——规则足够精巧的查表,也能演出七分像人的运营。剩下的三分,恰是机器学习要补的东西。分清这七分和三分,你看AI的眼光就跟大多数人不一样了。
这半个月的游戏时间没白费。觉得这两套实验有意思的,把文章转给那个总说"游戏AI会进化"的朋友,让他也录个屏试试,真理越辩越明嘛。