让AI学习的原理:数据喂养到模型毕业
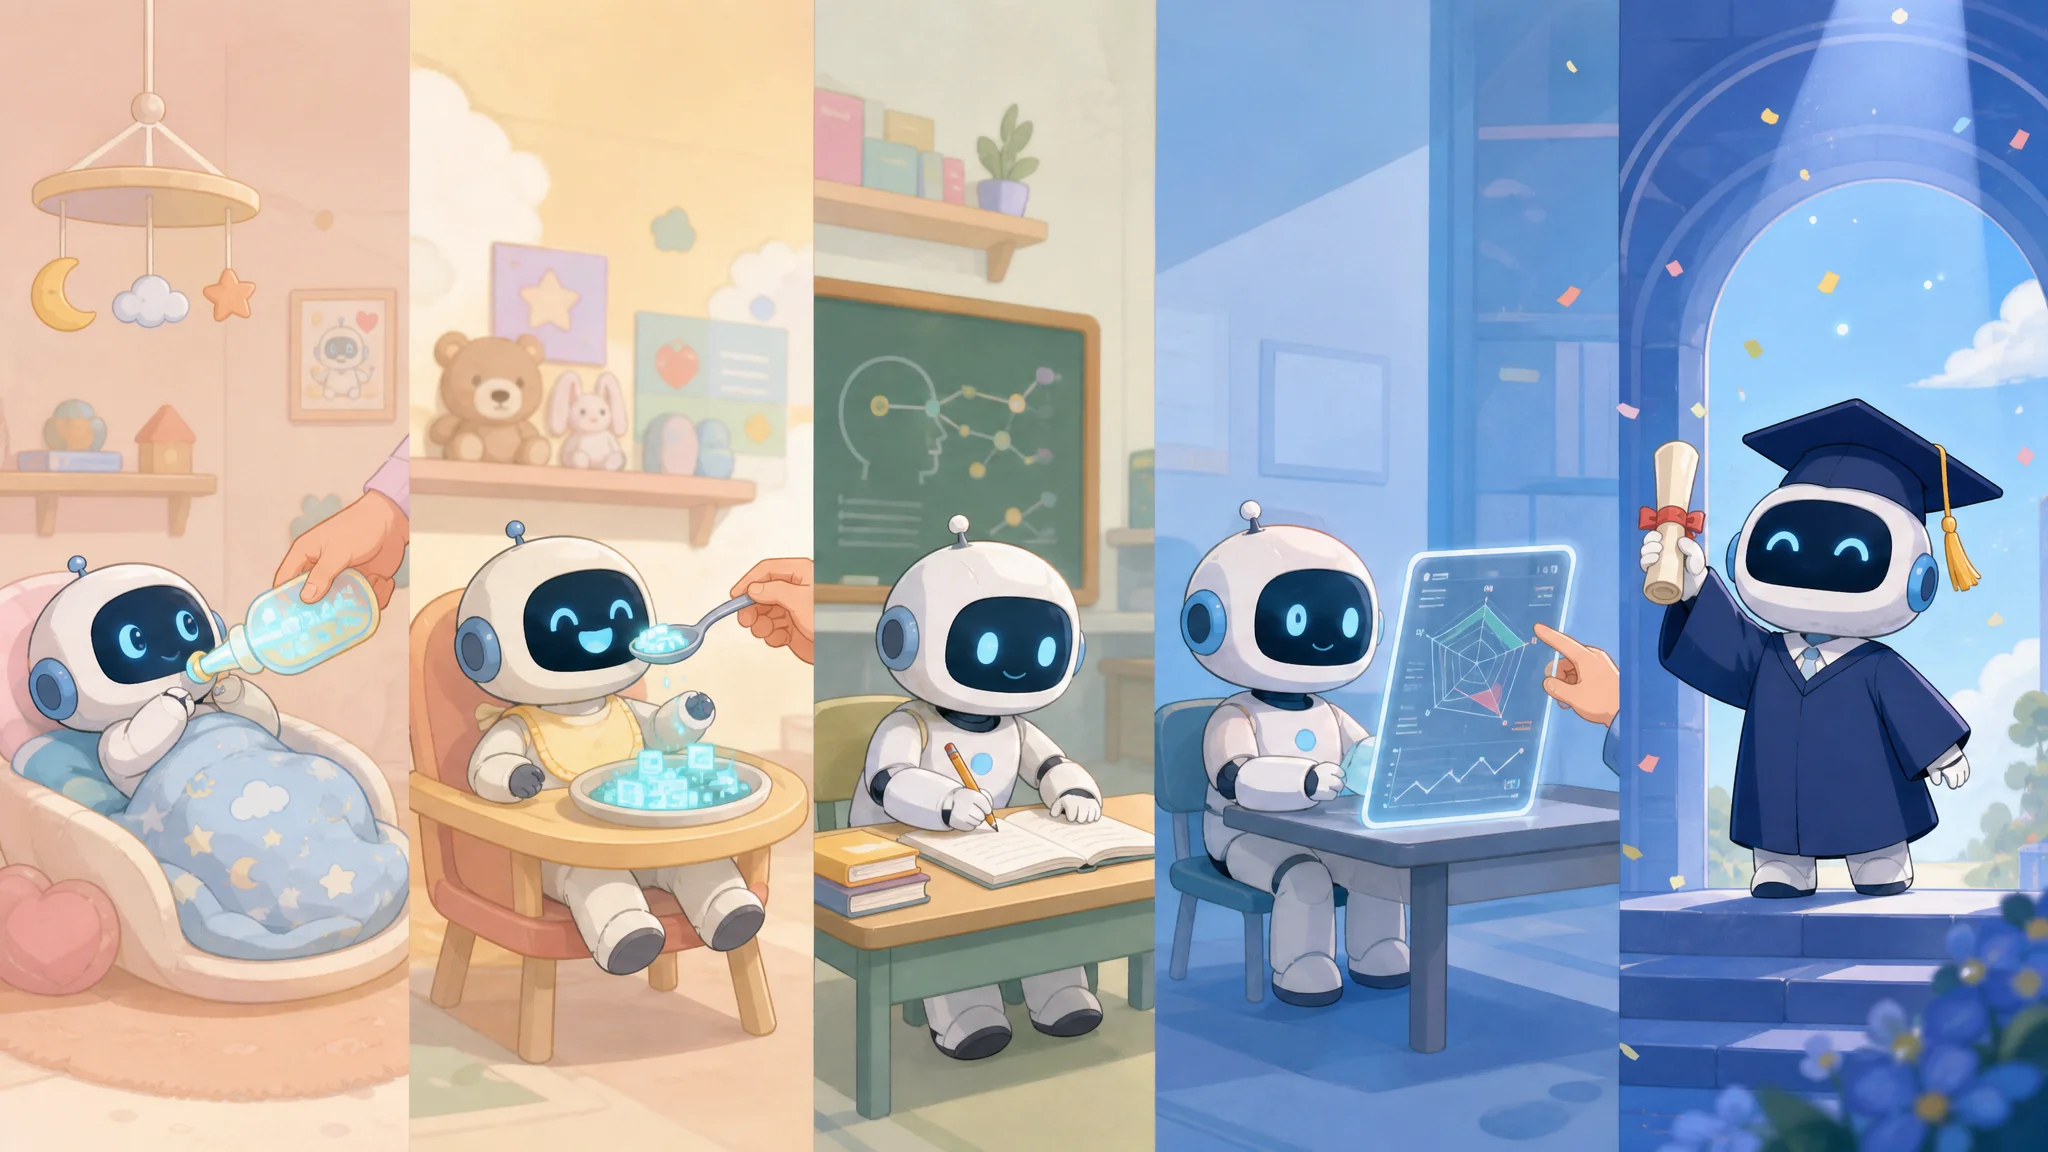

简单说:让AI学习的原理一句话讲完——拿海量带答案的题目反复喂它,答错就调参数,调到答对率不再涨为止。像养娃上学,伙食(数据)比天赋(算法)更常拖后腿。下面有我亲手喂模型的实验。
聊让ai学习的原理之前,先交代下我为什么敢聊。去年我用一个公开的猫狗图片数据集,在自己那台没有独显的笔记本上,从零训了一个分类模型。数据集小得可怜,两千张图,训练一轮十几分钟。就这一个小破模型,把"AI是怎么学习的"这件事从书本概念变成了我手上的肌肉记忆。下面讲的每一条,都对应我自己踩过的坑,不是转述百科。
把训练当成养娃:让AI学习的原理白话版
原子答案:AI学习=喂题+对答案+调参数的循环。数据是伙食,模型结构是脑子,训练就是一轮轮考试加纠错,直到成绩不再提高。展开讲讲这个养娃比喻,因为它真的好用。娃要上学,学校得有教材——对应训练数据,几千上万道带标准答案的题;娃本身有脑子——对应模型,一堆带旋钮的数学结构;上课过程——对应训练循环:做题、对答案、错了就微调脑子里的旋钮(参数),再做题,再对答案。
一模一样吗?差得远。娃做错一道题会举一反三,模型做错一万次也不会"明白",它只是把参数朝正确方向拧一小格。没有理解,全是拧旋钮。挺残酷的。但架不住它勤快:我那个模型一轮要看完全部两千张图,一轮下来几分钟,一晚上能复习几十轮,人类娃比不了。
我亲手喂的那个模型:数据才是亲爹
原子答案:同样的模型代码,喂两千张图,准确率只有七成出头;把数据清洗、数量翻倍后,啥代码没改,准确率冲到九成。数据质量决定上限。这是我那次实验最大的发现。第一版我用爬来的两千张图直接开训,里头混着卡通猫、毛绒玩具狗、还有人抱着真狗的自拍。模型训完,测试集准确率72%,惨不忍睹。我起初怀疑模型太简单,换了更复杂的结构,75%,聊胜于无。后来不死心,把数据重新筛了一遍:删掉卡通和玩具图,手动补标错标签的,再从公开数据集补了一批干净的,总量翻倍。模型结构一个字没动。准确率92%。
那晚我盯着屏幕愣了半天。原来我一直在鸡娃(改模型),问题是伙食(数据)。这个直觉后来到处能对上:工业界有句话叫"垃圾进垃圾出",斯坦福等机构多年的AI研究报告也反复强调数据质量对模型表现的决定性作用,参见斯坦福以人为本AI研究院发布的年度AI指数报告。想更细地了解数据和训练的关系,看我常用的高质量数据集清单那篇。
过程里还有个小插曲值得说。训练到第十几轮时,准确率在85%附近卡死,怎么都不涨了。我查日志才发现自己犯了个低级错误:学习率设太大,模型每次纠错都用力过猛,在正确答案附近来回横跳,就是不落座。把学习率从0.01降到0.001,两轮就破86%。这件事让我记住一个画面:调参数像给娃喂饭,一勺一勺喂能吸收,一盆扣下去全吐出来。
AI也会偏科:过拟合这关
原子答案:过拟合就是模型把训练题背下来了而不是学会了解法,训练分数很高、考试(新题)拉胯,治法是加数据、简化模型或者早停。这个词听着玄,换成养娃话术秒懂:题海里泡久了,娃把答案背下来了,模拟考门门满分,一上考场见新题就傻眼。我的模型也经历过:训练集准确率97%,测试集才81%,16分的差距就是"背题"实锤。
我用的土办法是早停——盯着测试集分数,发现它开始往下掉就停手,别恋战。另外把数据增强打开(图片随机翻转、裁剪),相当于一道题变着花样出,逼着模型学解法而不是背答案。两招下去,差距缩到5分以内。够用了。
训练和推理:毕业上班是两码事
原子答案:训练是上学,烧时间烧算力,一生一次;推理是上班答题,毫秒级出结果,天天干。你平时用的AI产品都是"毕业了的模型"在上班。这组概念最容易糊。拿我那个分类器说:训练那晚,笔记本风扇转得像起飞,十几分钟一轮;训练完保存模型文件,之后每次识别一张图,不到一秒。ChatGPT这类产品也一样,你打字它回答,用的是早就训练好的模型在推理,不是现场学习。它不记得你,每次都是新答主。
所以别再纠结"AI会不会越聊越聪明"——常规产品里不会,它下班不学习。训练和推理的区分,我在AI推理和训练的区别里展开写过,配了流程图级别的细节。
养娃式训练流程总结(可直接抄)
原子答案:五步循环——备数据、建模型、定损失函数、跑训练循环、验证调优。每一步都能对应到养娃:备教材、看资质、定考卷、上课、模考。我的实操顺序,第一次跑通全靠它:
- 备数据:找公开数据集,先小后大,两千条起步足够理解流程
- 建模型:入门直接抄现成结构,别自己发明轮子
- 定损失函数:它就是"扣分标准",分类任务用交叉熵,通用的
- 跑训练:盯着损失值往下掉,掉平了就停
- 验证:留两成数据当模考卷,训练时不许偷看
这套流程走下来,你对AI学习的理解会甩开只看科普文的人一大截。动手才是硬道理,这话在边学AI边训练模型里我喊过不止一次。
常见问题
让AI学习的原理里,AI真的"理解"了知识吗?
按现在的技术水平,不算理解,更像极度熟练的模式匹配。它把"输入到输出"的映射拧到了参数里,泛化得好就像懂了,泛化得差就露馅。别神化也别妖魔化,工具而已。
训练一个AI需要多少钱和设备?
玩票级别零成本:我那台没独显的笔记本加免费云额度就跑完了。大模型是另一个世界,头部公司训一次动辄数百万美元算力。跨度大到离谱,中间没有平滑过渡,选好自己的档位就行。
数据越多模型一定越准吗?
不一定,干净比多重要。我的实验里删掉脏数据比再加一倍脏数据都管用。数据量到某个程度后收益会递减,这时候该回头查标注质量了。
普通人有必要懂训练原理吗?
看你目标。只想用好AI工具,不必懂,会用提示词就行,参考用AI学AI的提问框架。想入行或者想看清AI产品的能力边界,值得亲手训一个,成本一个周末。至于"AI到底有没有学习能力"这种辩论,这个训练实验给了我的答案。
写在毕业典礼之后
把让ai学习的原理讲透,其实就三句话:喂题、对答案、拧旋钮;伙食决定上限;毕业之后不再成长。我那个92%的猫狗分类器现在还躺在硬盘里,偶尔拿新图逗逗它,看它把一只仓鼠认成狗。养娃式比喻的最后一条忠告:模型毕业只是开始,真实世界的题永远比训练集刁钻。想顺着这条线继续深入,机器学习入门白话版适合补基础,监督式学习白话拆解讲最常用的训练方法。权威教材我推荐《动手学深度学习》,免费全本还能跑代码。这篇要是帮你把训练原理想通了,转给还在把AI当黑盒供着的朋友,拆开看看没那么神。