监督式学习是什么?AI训练里最常用的方法白话讲透

简单说:ai监督式学习就是拿带标准答案的数据训练模型,模型照着答案校准自己,学会以后给新数据打答案。垃圾邮件过滤、人脸解锁、银行风控背后全是它。想入门机器学习,从它下手最快。
ai监督式学习这个词,我头一回见是在一份机器学习课程大纲里。旁边还列着无监督学习、半监督学习,我盯着屏幕看了十分钟,脑子里就一句话:这都是啥。直到自己动手跑出第一个分类模型,我才咂摸出味来——这东西根本不玄乎,它就是你上学天天经历的事:老师批改作业。
这篇文章干两件事。把概念用大白话拆透,再把我的鸢尾花实验完整摊开,包括那个让我白高兴一场的乌龙。不抄教材,全是手上过的。
先立地基。监督式学习里的"监督",指数据自带标准答案。你喂给模型一大堆配好对的例子——输入长这样,正确输出是那样——它的活儿是从中找规律,等新数据只有输入没有答案时,自己算出输出。维基百科的监督式学习词条管这叫"从标记数据学映射函数",说法偏学术,内核就是对着答案学。
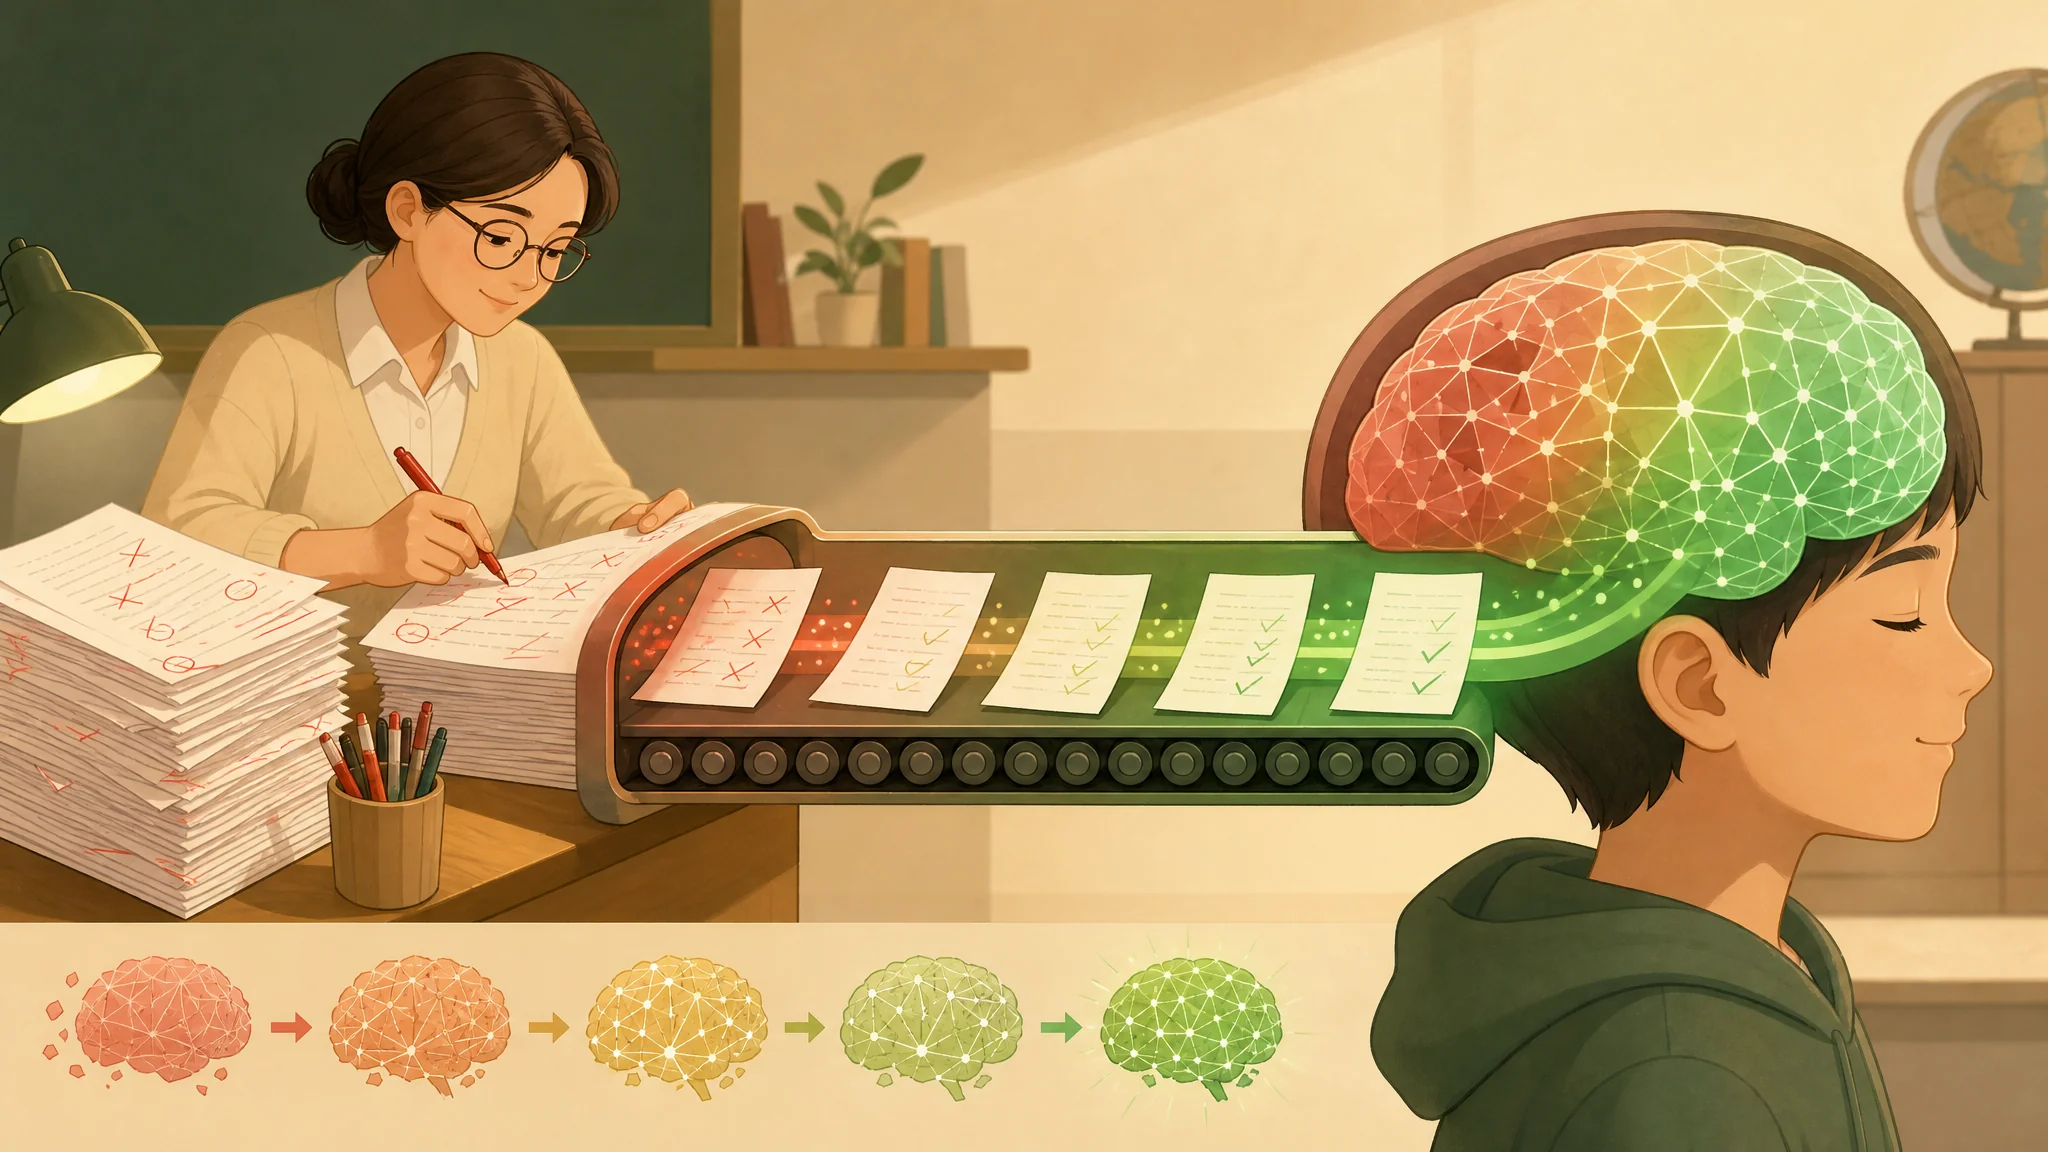
老师批改作业这个比喻,贴得很。学生做题,老师逐题判对错,学生看着红叉改思路,下次同类题就不错了。模型同理:这朵花它猜错了种类,这个错误会变成信号,反过来拧它内部的参数,让它下次错得少点。老师全程在场,所以叫监督。没老师、没答案、让模型自己在数据里扒结构的,那是无监督学习,两家的差别后面细说。
我的第一个模型:拿鸢尾花数据集开练
原子答案:鸢尾花数据集是机器学习界最经典的入门数据,150条记录、3种花、每条4个测量值。我用scikit-learn的KNN算法,在30%的测试集上跑出95.6%的准确率,全程约25分钟,其中15分钟花在装库上。
为什么偏偏是鸢尾花?这份数据1936年就被统计学家费雪拿来做分析了,一百五十朵花,每朵量花瓣长宽、萼片长宽四个数,归属山鸢尾、变色鸢尾、维吉尼亚鸢尾三种。它的妙处在于:小,加载零等待;干净,没有缺失值;难度适中,一种轻松分开,另外两种有交叠,能让你亲眼看模型犯错。有送分题,也有拉分题。
环境是我办公那台轻薄本,Python加scikit-learn,scikit-learn官方文档的第一个入门例子拿的就是它。代码量说出来你可能不信,核心就五句:载入数据、切训练测试集、建模型、fit、predict。真就五句。
接着说乌龙。首跑完屏幕上蹦出"准确率100%",我截图就发群里,一个学统计的朋友慢悠悠回了句:"该不会拿训练数据测的吧?"一查,还真是。我忘了切测试集,等于学生做完卷子,又拿同一张卷子当考题,能不满分吗。丢人。但印象深到我现在写机器学习代码,train_test_split永远敲在第一行。
改完之后的真实成绩:150条数据按7比3切开,45条做测试。KNN取k等于3时,45条错2条,95.6%。我又顺手扫了几个k值,记了张表:
| k值 | 测试集准确率 | 我的观感 |
|---|---|---|
| 1 | 93.3% | 错得没规律,太敏感 |
| 3 | 95.6% | 最稳,就它了 |
| 5 | 95.6% | 和k=3打平,无惊喜 |
| 15 | 91.1% | 开始糊,分不动了 |
错的2条全落在变色鸢尾和维吉尼亚鸢尾的交界地带,山鸢尾零失误。这跟数据的脾气完全对得上:一种天生好认,另外两种本是近亲,花瓣尺寸区间重叠,神仙来了也得错几条。看到模型犯的错跟人类专家会犯的错一个样,我对"从数据里学规律"这件事算是有了实感。挺奇妙的。
原始数据想自己下的,UCI机器学习库的鸢尾花页面有存档,公开免费。其实scikit-learn装好就自带,一行代码载入,图省事直接用它。
ai监督式学习和无监督学习,选型时我站谁
原子答案:有标准答案可拿、标注成本扛得住,就上监督式学习,它准得多也贵得多;答案拿不到或压根不存在,才退到无监督。我的态度不含糊:能用监督就别硬凑无监督。
差距的根子在"有无反馈"。监督式学习每一步都知道自己错多少,能照着错误校准;无监督学习没有对错概念,模型只能把相似的东西归成堆,归得对不对还得人来解读。做垃圾邮件识别,监督式给你一个明确的拦截概率;无监督只能告诉你"这批邮件长得像",然后呢?定性还是得人来。生产环境里能直接干活的模型大多是监督式的,原因就在这。
代价同样明摆着:监督式吃标注。一百万封邮件每封都要人先标好是不是垃圾,这笔标注费常常比训练本身贵。省标注的招数有不少,比如主动学习,让模型自己挑最拿不准的样本给人标,我拿它跑过对照实验,标注量省了一半还多。这类招数全是架在监督式学习上的省钱技巧,地基还是监督那套。
监督式学习藏在哪?你一天要被它服务几十次
原子答案:垃圾邮件过滤、人脸识别解锁、银行风控评分、语音助手听懂人话,背后全是监督式学习。这些模型每天替你做几十次判断,你只是没察觉。
说个我追过的具体例子。信用卡审批模型,历史上有几十万条"申请人特征—最终有没有逾期"的记录,条条带答案,教科书级的监督式学习场景。模型学出来的规律,会直接决定你的卡下不下、额度多少。这类场景监管要求可解释,决策树系算法用得最多,跟新闻里天天讲的大模型属于两个世界。
话说回来,大模型也不是监督式学习的对立面。ChatGPT们训练里的对齐阶段,靠人类标注员写示范答案、给回答排序,学名监督微调——一样是老师批作业,只是批的是作文。想顺着这条路往下啃的,让AI学习的原理那篇把数据喂养到模型毕业的全流程拆开了,值得接着读。
新手该从ai监督式学习入门吗?
原子答案:该,而且就该从它入门。概念最少、反馈最直接、练手资源最丰富,第一个模型一个晚上就能跑通。零基础从这里起步,性价比没有对手。
我的理由很实在:监督式学习有明确对错,学起来不自我怀疑。参数调一下,准确率从93涨到95,进步看得见摸得着。无监督跑完一堆聚类,好坏全凭主观解读,新手特别容易陷进"我到底学会没有"的虚无。先在监督式学习里养手感,再看别的分支,一路都顺。
具体路线我押三个算法按顺序啃:线性回归、决策树、KNN,别贪多。这三个各代表一类思路,吃透了,后面见到的算法全是变奏。展开版写在AI算法学习从哪个算法开始那篇里。概念还没理顺的话,机器学习到底是什么的白话版当前置阅读,读完再回来动手,顺序别反。
常见问题
学监督式学习一定要会写代码吗?
想跑通第一个模型,Python会装库、能照例子改参数就够了,scikit-learn对新手相当友好。只想搞懂概念不动手,把这篇文章读完也能跟人聊明白七成。
鸢尾花数据集去哪免费拿?
scikit-learn自带,装好库一行代码载入,不用额外下载。想看原始出处的,UCI机器学习库有存档,正文里给了链接,公开免费。
训练集和测试集为什么必须分开?
不分开等于拿作业当考题,模型背了答案当然满分,但换道新题就露馅。我那个100%准确率的乌龙就这么来的。用没见过的数据考它,分数才算数。
监督式学习准确率到多少算能用?
没有统一分数线,看犯错的代价。垃圾邮件误拦一封损失小,95%能上线;医疗诊断错一次代价大,99%都不敢说稳。标准由业务定,不由算法定。
写这篇时翻了翻相册,那个错误的"100%"截图还躺着。留着吧,提醒自己:模型吐出漂亮数字,先想想这数字怎么来的。ai监督式学习说穿了就是对着答案学规律,这一层想通,机器学习的大门等于开了一半。
身边要有人正打算入门机器学习,把这篇转给他,省得他也在100%上白高兴一场。